 NexCheck-筛号平台
手上有一份几万条的客户手机号名单,要知道哪些号码开通了 WhatsApp,直接把 Excel 丢进检测工具通常会得到一堆看不懂的「无效」。多数时候问题不在检测本身,而在名单进入检测之前没有处理干净。
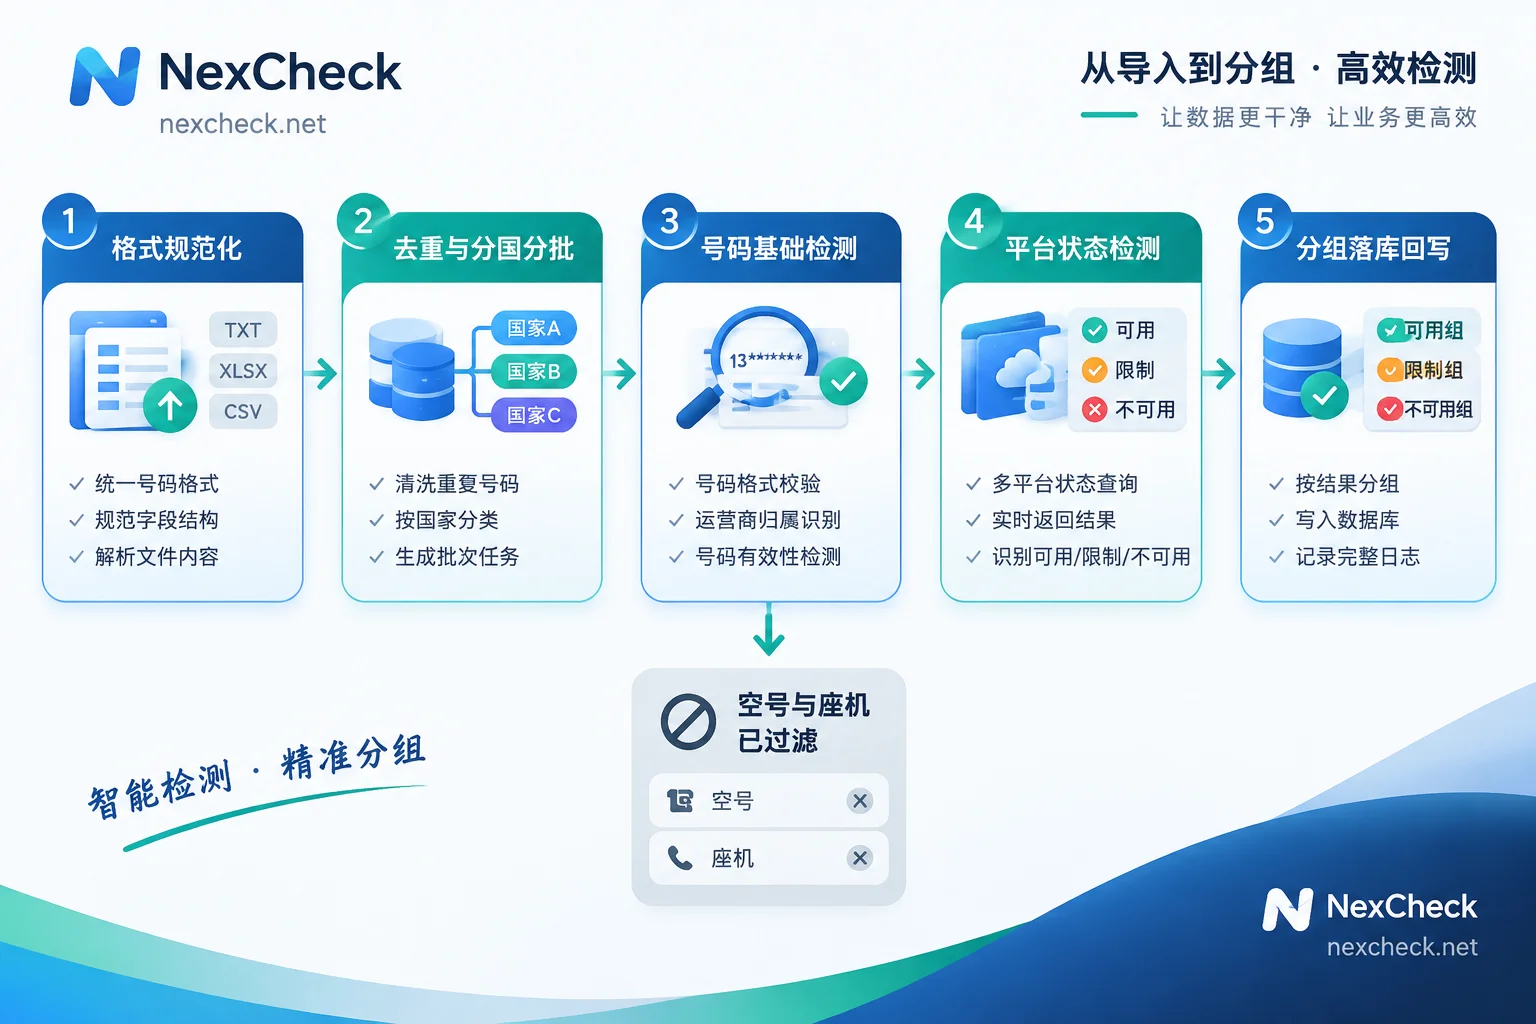
可用的顺序是这五步:
- 本地把号码清洗成 E.164 国际格式;
- 去重,并按国家代码拆成若干批;
- 先跑号码基础检测,过滤空号与非移动号段;
- 再提交 WhatsApp 平台状态检测;
- 结果按多列落库,再按有效/无效分组回写业务系统。
第 3 步经常被跳过,但它决定了你后面按条付费的量有多大浪费。下面按顺序说每一步要做什么、字段怎么读。
第一步:号码必须先变成 E.164
WhatsApp 账号完全以电话号码为标识,没有独立用户名体系。这意味着号码写法只要偏一点,检测系统就可能把它当成一个不存在的号,返回「未注册」——而实际上这个号码的主人每天都在用 WhatsApp。
E.164 的规则很短:加号开头、国家代码、本地号码,中间不带任何空格、括号、破折号,总长度不超过 15 位数字。落到实际名单上,需要改写的主要是这几类:
- 带分隔符的:
+44 (0)20 7946 0958→+442079460958。括号、空格、连字符全部去掉。 - 带前导 0 的:很多国家的本地写法会在区号或手机号前加一个 0,这个 0 是国内拨号前缀,加了国家代码之后必须删掉。英国
07700 900123对应的国际格式是+447700900123,不是+4407700900123。 - 阿根廷:国家代码 54 与区号之间要保留
9,同时去掉本地写法里的15。+54 11 15 1234 5678应写成+5491112345678。 - 墨西哥:国家代码 52 之后需要包含
1,写成+521...。
还有一类隐蔽的问题:名单从 Excel 导出时,+ 号丢失、长号码被转成科学计数法、前导 0 被单元格格式吃掉。这类损坏在肉眼看名单时不明显,但会整批拉低命中率。导出前把号码列设成文本格式,或者直接用 txt 存储,能省掉很多返工。关于几类脏号码的具体改写规则,可以参考海外号码筛选前怎么做E.164归一化。
第二步:去重并按国家代码分批
清洗完先去重。同一个客户在不同表里留过两次号码、同一号码有加号版和不加号版,规范化之后才能真正判定为重复。去重放在规范化之后做,顺序反了会漏掉一半重复项。
然后按国家代码拆批。分国跑有三个实际理由:
- 不同国家的号码长度和号段规则不同,混在一起时你很难判断某一批的失败是格式问题还是真实未开通;
- 某些市场 WhatsApp 渗透率高、某些市场用户主要在别的平台,分国之后你能直接看出哪批名单值得继续投入;
- 出结果后按国家对比命中率,异常低的那一批通常是格式规则没处理对(比如阿根廷、墨西哥这类有特殊写法的国家)。
如果你不确定某个国家的号码位数、区号规则和当地主流通讯平台,可以先查按国家整理的号码格式与平台分布,再决定这批名单该筛哪个平台。
第三步:先做号码基础检测,再做平台检测
这一步是成本控制,也是准确度控制。
WhatsApp 本质上是为移动号码设计的。固定电话一般只能通过 WhatsApp Business 应用接收语音验证码来完成注册,普通个人号很少落在座机号段上;VoIP 虚拟号段则常被平台风控限制。所以名单里混着的座机、传真号、已停机空号、明显的高风险虚拟号,在提交平台检测之前就应该被摘出去。
号码基础检测能给出的通常包括:号码是否为空号、设备类型是移动号还是座机/VoIP、归属运营商、是否属于高风险号段。这层是纯号码属性判断,不涉及任何社交平台账号信息,做完之后你的名单会瘦一圈,剩下的才是值得按条付费去查 WhatsApp 状态的部分。
实操上建议把三类号码分开存:确定空号的直接归档不再复用;座机/VoIP 单独放一组(这类号码在 B2B 名单里可能仍有价值,只是不走 WhatsApp);移动号进入下一步。WhatsApp空号过滤怎么做里有这三类的分开处理方式。
第四步:提交平台状态检测,两种方式怎么选
到这一步才轮到真正的 WhatsApp 号码检测。
先说一个不要做的事:自己写脚本去遍历探测。WhatsApp 客户端判断通讯录里谁注册了,走的是把号码做哈希后与服务端比对的机制,官方对异常高频的批量遍历有明确的风控与封号处理。用自己的账号或模拟网页端去跑几万条名单,结果通常是账号被封、数据还没拿全。名单检测应当通过正规的批量接口提交,这既是稳定性问题,也是账号安全问题。
在 NexCheck 的 WhatsApp 平台页上可以看到当前这个平台具体支持哪些检测项,以及按条计价的单价。检测项清单和价格会调整,以平台页当时显示的为准,不要照抄任何文章里写死的字段表。
提交方式有两种:
控制台上传适合一次性名单、临时核验、以及还在评估阶段的团队。把清洗好的 txt 或 csv 传进去,单批不限量,跑完按有效与无效分组导出。上传前的文件准备有几处容易踩坑(编码、列头、换行符、单列还是多列),可以对照WhatsApp CSV筛号:上传前6处文件准备要点。
REST API 适合已经有 CRM、需要把检测变成常规动作的团队。典型做法是提交任务拿到任务 ID,任务完成后由 Webhook 回推结果,避免长时间轮询。如果你的名单是持续流入的(比如表单新增线索),API + Webhook 才能做到线索一进来就带着状态字段落库。具体的任务提交、状态机和回写设计见WhatsApp筛号API怎么接入;至于什么量级该用轮询、什么时候必须上 Webhook,按任务量与延迟容忍度分档那篇给了取值区间。
一个提醒:名单是你自己的客户数据,检测方只在任务范围内处理。但数据来源和使用用途是否合规,仍然由持有名单的一方负责,跨境名单尤其要先确认这一点再上传。
第五步:字段怎么读,哪些空值不能当成「没这个人」
检测结果最容易被误用的地方,是把它压缩成一个「有效/无效」的布尔值存进 CRM。真正有用的信息在明细字段里。
各平台可返回的检测项不同——开通状态、注册时间、活跃情况、是否封禁、性别年龄等属性,不是每个平台都有,也不是每个号码都齐全。WhatsApp 具体能拿到哪些,以平台页的检测项清单为准。读字段时把握三条:
开通状态是最硬的一条。 它回答的是这个号码上是否存在 WhatsApp 账号。这条为否,后面所有扩展字段都没有意义。
头像、个性签名、公开昵称这类字段为空,不代表号码未开通。 这些内容受用户自己的隐私设置控制,可以设为仅联系人可见或完全不公开。一个把隐私设置拉满的用户,检测结果就是「已开通 + 头像为空 + 签名为空」。如果你的筛选逻辑写成「有头像才算活跃客户」,会把一批真实用户误杀。
注册时间、活跃度这类字段是分层依据,不是真伪判断。 它们适合用来给名单排优先级——比如把近期活跃的放前面跟进——但不适合当成「这个号码有效」的唯一标准。
落库时建议保留多列:原始号码、规范化后的 E.164、国家代码、基础检测结果(空号/移动/座机/VoIP)、平台开通状态、可得的扩展字段、检测时间戳。最后这一列很重要,号码状态会变,半年前的检测结果不能当作当下的事实,带上时间戳才知道什么时候该重跑。这套多列存法的具体设计在批量号码验证别只看有效无效里展开过。
结果不理想时先查哪里
如果某一批的开通比例明显低于其他批次,按这个顺序排查:
- 看国家代码是否统一。整批偏低,最常见原因是这个国家的写法规则没处理对(前导 0、阿根廷的 9、墨西哥的 1)。抽十条手工核对格式,比重跑一遍便宜。
- 看名单来源和年龄。三年前采集的号码、来源不明的采购名单,本身空号率就高,这是数据问题不是检测问题。先看基础检测那一层的空号比例。
- 看是不是拿扩展字段当判断依据。把「头像为空」「签名为空」误算进无效组,会凭空压低有效率。
- 看号段类型。B2B 名单里座机占比高是正常的,这些号码不该进 WhatsApp 检测批次,混进去会稀释整体比例。
整个流程走通之后,常规做法是把第一、二步做成固定的清洗脚本,第三、四步通过 API 挂在名单入库环节,新号码进来自动带状态落库。这样名单质量就不再是每次活动前临时补救的事,而是一直维持在可用状态。
要看 WhatsApp 当前支持的完整检测项和单价,或者比较其他平台在你目标市场能查到什么,可以直接对照各平台能查什么再决定这份名单该往哪走。


评论(0)