 NexCheck-筛号平台
一个号码是不是 WhatsApp Business,从号码本身看不出来。它不是号段特征,也不是运营商属性,而是这个号码在 WhatsApp 网络里注册时选择的账号形态。所以判断路径只有一条:先确认号码在 WhatsApp 上注册,再读取这个账号的商业标识字段。
这决定了处理顺序——名单清洗 → 提交检测 → 读注册状态 → 读商业标识 → 分组回写。跳过前面任何一步,后面的字段都会失真或大量缺失。
先分清四种账号形态
运营同事说「商业号」的时候,往往指的不是同一件事。WhatsApp 的账号体系在平台层面有明确层级:
个人账号(Personal)。普通用户注册,只有昵称、头像和一条个性签名,没有任何商业元信息。
WhatsApp Business App 账号。小微商户用独立的 Business 应用注册,可以填营业时间、地址、简介、商品目录。这类账号在检测中会带上商业标识。
WhatsApp Business Platform(API)账号。企业通过官方 API 接入,通常由服务商或自建系统管理,同样携带商业属性。
Official Business Account(认证号)。在上述商业账号基础上通过了 Meta 的品牌认证,会有官方标识。这是商业账号里的一个子集,不是并列类型。
对名单筛选来说,最实用的切分是两层:是不是商业账号(对应 is_business 这类布尔字段),是不是经过认证的官方账号。前者用来区分 B 端联系人和 C 端个人用户,后者用来判断对方是有一定规模的品牌方还是散户商家。
这个区分很有实际价值。比如做 B2B 线索清洗时,名单里的商业账号往往对应真实在运营的商户,可以和个人号分开走不同的跟进流程;做跨境供应链的名单,商业账号的占比也能反过来验证这批数据的来源质量。
名单清洗:提交前必须做完的三件事
检测结果里大批量出现「未注册」,一半以上的情况不是号码真的没开通,而是提交的格式让系统匹配不上。提交前处理干净这三件事:
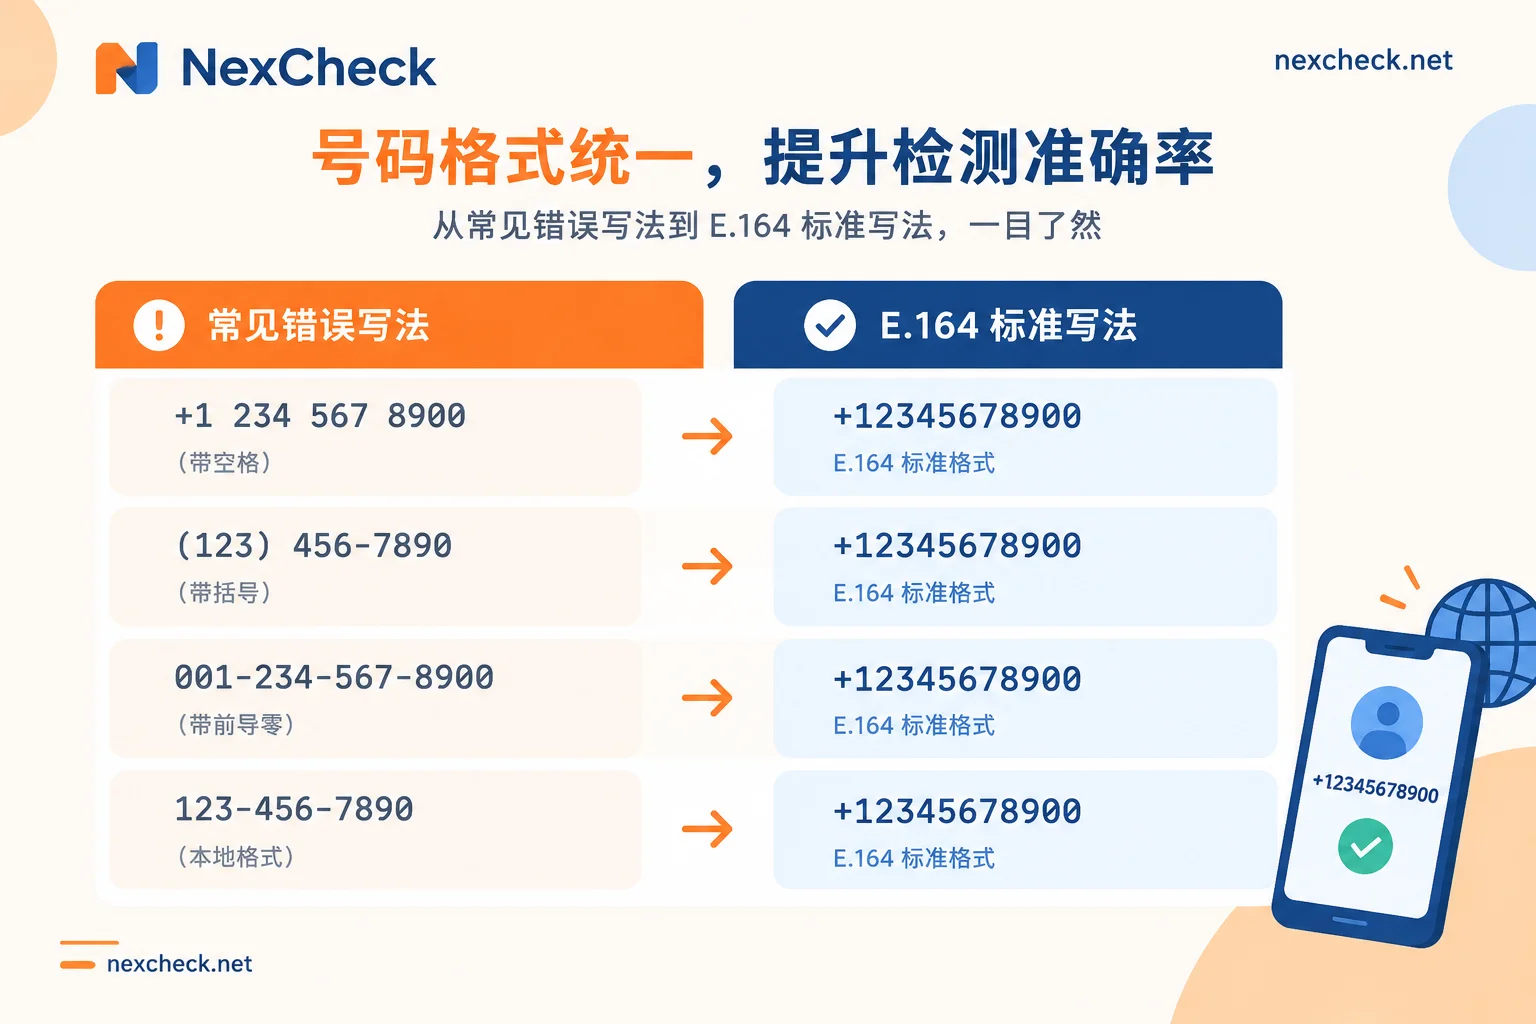
第一,统一成 E.164。 去掉空格、破折号、括号、加号以外的所有符号,补上国家代码。这是唯一能跨国通用的写法。
第二,处理本地呼叫冠码。 很多国家的本地写法带前导 0(如英国 07xxx、德国 015x),转国际格式时这个 0 要去掉。少数国家有更特殊的规则——阿根廷移动号在国家代码后带 9,墨西哥历史上有过 1 的写法且已变更,这两类如果按通用规则处理会大面积失配。具体规则可以参考WhatsApp E.164 格式转换规则里的国家清单。
第三,去重。 同一个人在 CRM 里可能有「带 0 的本地写法」和「带国家码的国际写法」两条记录,清洗成 E.164 之后才能真正识别为重复。去重要在格式统一之后做,顺序反了会漏掉一批。
混合多国的名单,建议按国家代码先分组。一是方便对每个国家单独校验号码长度和号段合法性,二是不同市场的开通率、商业号占比差别很大,分开跑更容易看出哪批数据有问题。各国的号码位数与常见写法可以查区域号码格式页。
返回字段怎么读
提交之后,一条号码的检测结果通常包含这几类信息。字段名各平台叫法不同,含义大体一致:
注册状态。这个号码在 WhatsApp 网络里是否存在活跃账号。这是所有其他字段的前提——如果这里是否,后面的商业标识、签名都不会有值。
商业标识(is_business)。布尔值。为真表示该账号是通过 Business App 或 Business Platform 注册的商业账号。这是本文要找的核心字段。
认证标识。区分普通商业账号和 Official Business Account。名单里这类通常占比不高,但往往是价值最高的一批。
公开签名 / 状态文本。个人号的个性签名,商业号可能是业务简介。有内容说明账号在被实际使用;为空不能直接判定为废弃,因为用户可能从没设置过。
头像可见性。有头像 URL 或头像存在标记,是账号活跃度的一个辅助信号,同样不是硬指标——隐私设置能把它关掉。
账号可用状态。是否处于封禁、受限等异常状态。已封禁的号码即使显示注册过,对后续业务也没有意义,应该和未注册的一起归入无效。
读这些字段有一条原则:注册状态是硬结论,其余字段是概率性信号。一个没有签名、没有头像的商业号,不代表它不活跃,只代表这些信息对外不可见。把辅助字段当成过滤硬条件,会误杀掉一批真实有效的联系人。
关于字段的更多解读思路,可以参考WhatsApp 号码有效性检测的字段解读部分。
结果怎么分组
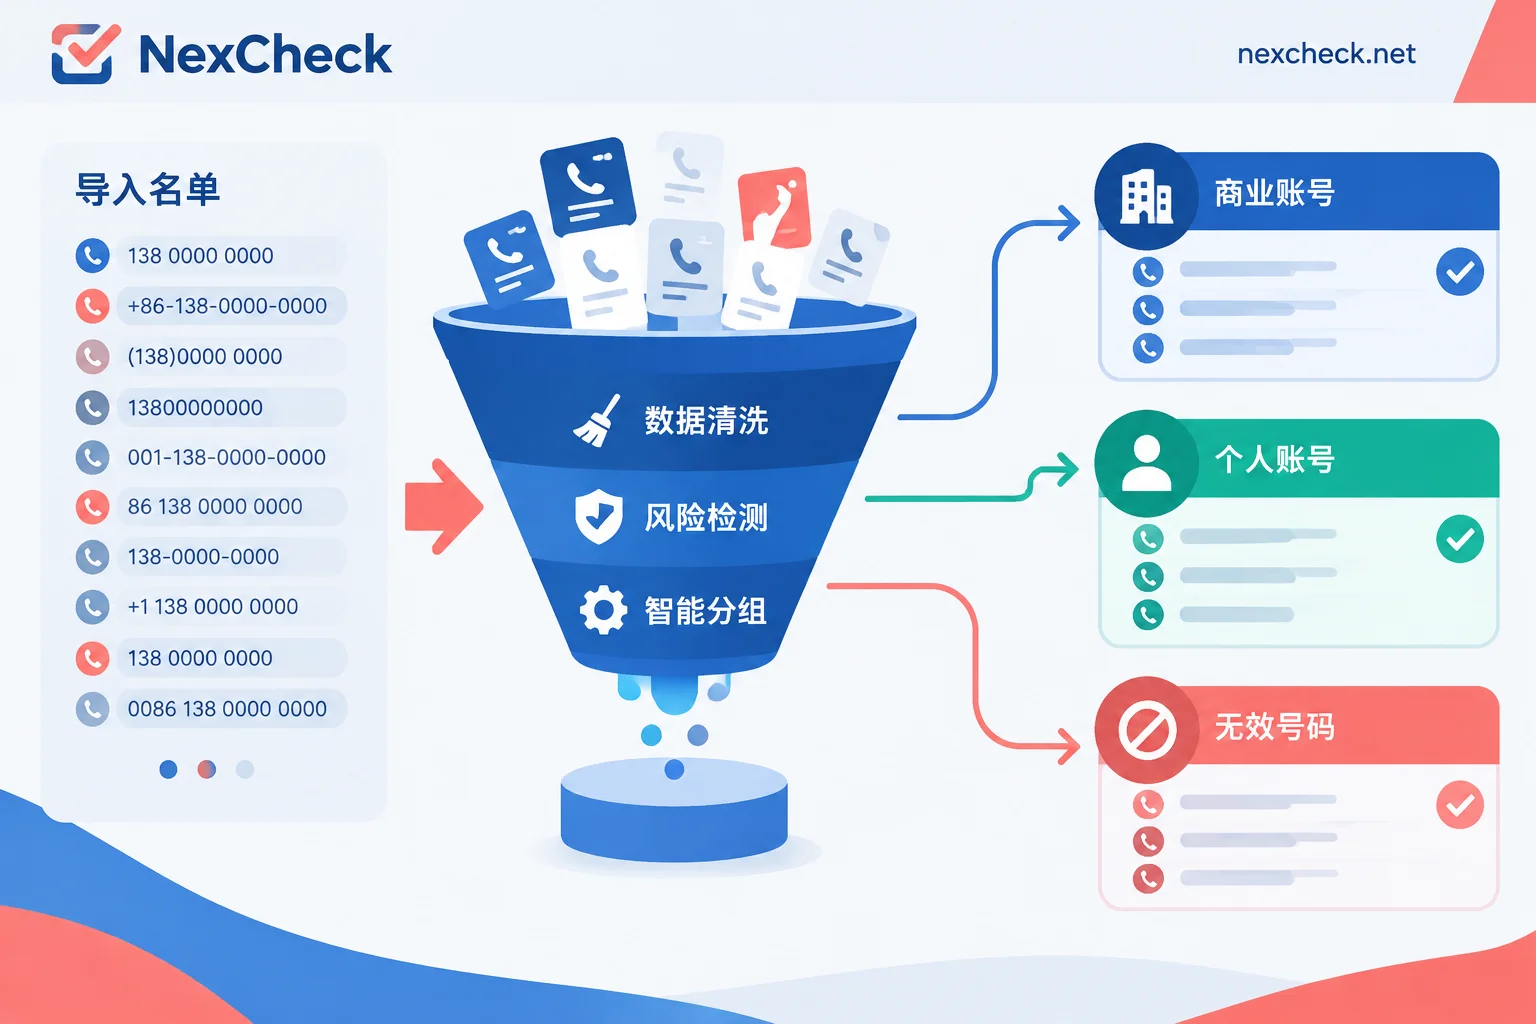
拿到结果之后,按业务用途分三组通常就够用:
A 组:商业账号。注册状态为真且商业标识为真。如果需要,再从中拆出认证号做单独标记。这组对应 B 端场景下最明确的目标。
B 组:个人账号。注册状态为真、商业标识为假。C 端场景的主力名单。
C 组:无效。未注册、已封禁、格式无法解析的全部归这里。格式问题导致的失败最好单独标记,因为这批是可以修复后重跑的,和真正未注册的性质完全不同。
分组导出时注意保留原始号码列。CRM 回写要靠这一列做匹配,只导出清洗后的 E.164 会让对账变麻烦。
实际操作上,NexCheck 的做法是控制台上传 txt 或 csv,按条计价,结果按有效与无效分组打包下载;WhatsApp 平台页上列了当前支持的检测项,因为检测项和单价会随协议层能力调整,具体以那个页面为准。如果名单里还混着大量来源不明的号码,可以先跑一轮号码基础检测(空号、设备类型、高风险号),把明显无效的过滤掉再进平台检测,这样按条计费的部分不会浪费在必然失败的号码上。
网页端还是 API
判断标准很简单:这件事是一次性的还是持续的。
一次性清洗历史名单、月度做一次存量盘点,用控制台上传就够了。上传、等结果、下载分组文件,不需要开发介入。
如果检测要嵌进业务流程——新线索进入 CRM 时自动判断是否为商业账号、每天增量跑一批、检测结果要驱动后续的分配规则——就走 REST API。典型的接法是异步任务:提交名单拿到任务 ID,任务完成后通过 Webhook 收到推送,再把 is_business 等字段写回联系人记录的自定义属性。
为什么优先 Webhook 而不是轮询?批量检测的完成时间取决于名单规模,轮询要么间隔太短浪费请求,要么间隔太长引入无谓延迟。只有在任务量很小、或者你的系统不方便对外暴露回调地址时,轮询才更合适。这两种方式的取舍可以看号码检测用轮询还是 Webhook 回调,接入的具体步骤在WhatsApp 筛号 API 对接方案里有展开。
回写时建议在 CRM 里至少建三个字段:账号类型(商业/个人/无)、检测时间、上次检测结果。第二个字段尤其重要——号码状态会变,一年前检测的结果不能当成现在的事实。带上时间戳,才知道什么时候该重跑。
有些字段拿不到,这是边界不是故障
检测能读到的,是账号在 WhatsApp 网络中对外公开的那部分状态。用户的隐私设置会直接影响可见范围:头像可以设为仅联系人可见,最后上线时间可以完全隐藏,个性签名也可以设为不公开。这些情况下返回空值是正常的,不代表账号有问题,也不该被解读为检测失败。
商业账号的一些深层信息——比如完整的商品目录、业务类目——是否能批量提取,取决于底层协议当前支持到什么程度,不同时期能力不一样。需要这类字段的话,直接看平台页上公布的当前检测项清单,不要按别的平台的字段表来假设。
还有两条底线要说清楚:名单必须是业务方自有的合法数据,来源和用途的合规性由数据持有方负责;检测本身只解决数据质量问题——哪些号码有效、属于什么类型、该归到哪一组,不涉及任何触达动作。这两件事在流程上是分开的,在职责上也是分开的。
一份名单从头跑一遍
把上面的内容串成可执行的顺序:
- 导出名单,保留原始号码列和唯一 ID
- 清洗成 E.164:去符号、去前导零、补国家码,注意阿根廷墨西哥等特殊规则
- 按国家代码分组,各自校验号码长度合法性
- 去重,记录重复项与主记录的映射关系
- 可选:先跑号码基础检测,滤掉空号和高风险号
- 提交 WhatsApp 平台检测(控制台上传或 API)
- 读结果:先看注册状态,再看商业标识和认证标识
- 分三组导出:商业号 / 个人号 / 无效,格式错误单独标记
- 回写 CRM,带上检测时间戳
- 格式错误那批修复后重跑一次
第 10 步经常被跳过。一批名单里因为格式问题失配的号码,修复后重跑通常能捞回一部分有效联系人,成本远低于重新获客。
要开始跑自己的名单,可以在 WhatsApp 平台页确认当前支持的检测项,或者在各平台能查什么对比一下不同平台的字段差异——同一份名单在不同平台能拿到的属性不一样,先看清楚再决定跑哪个。


评论(0)