 NexCheck-筛号平台
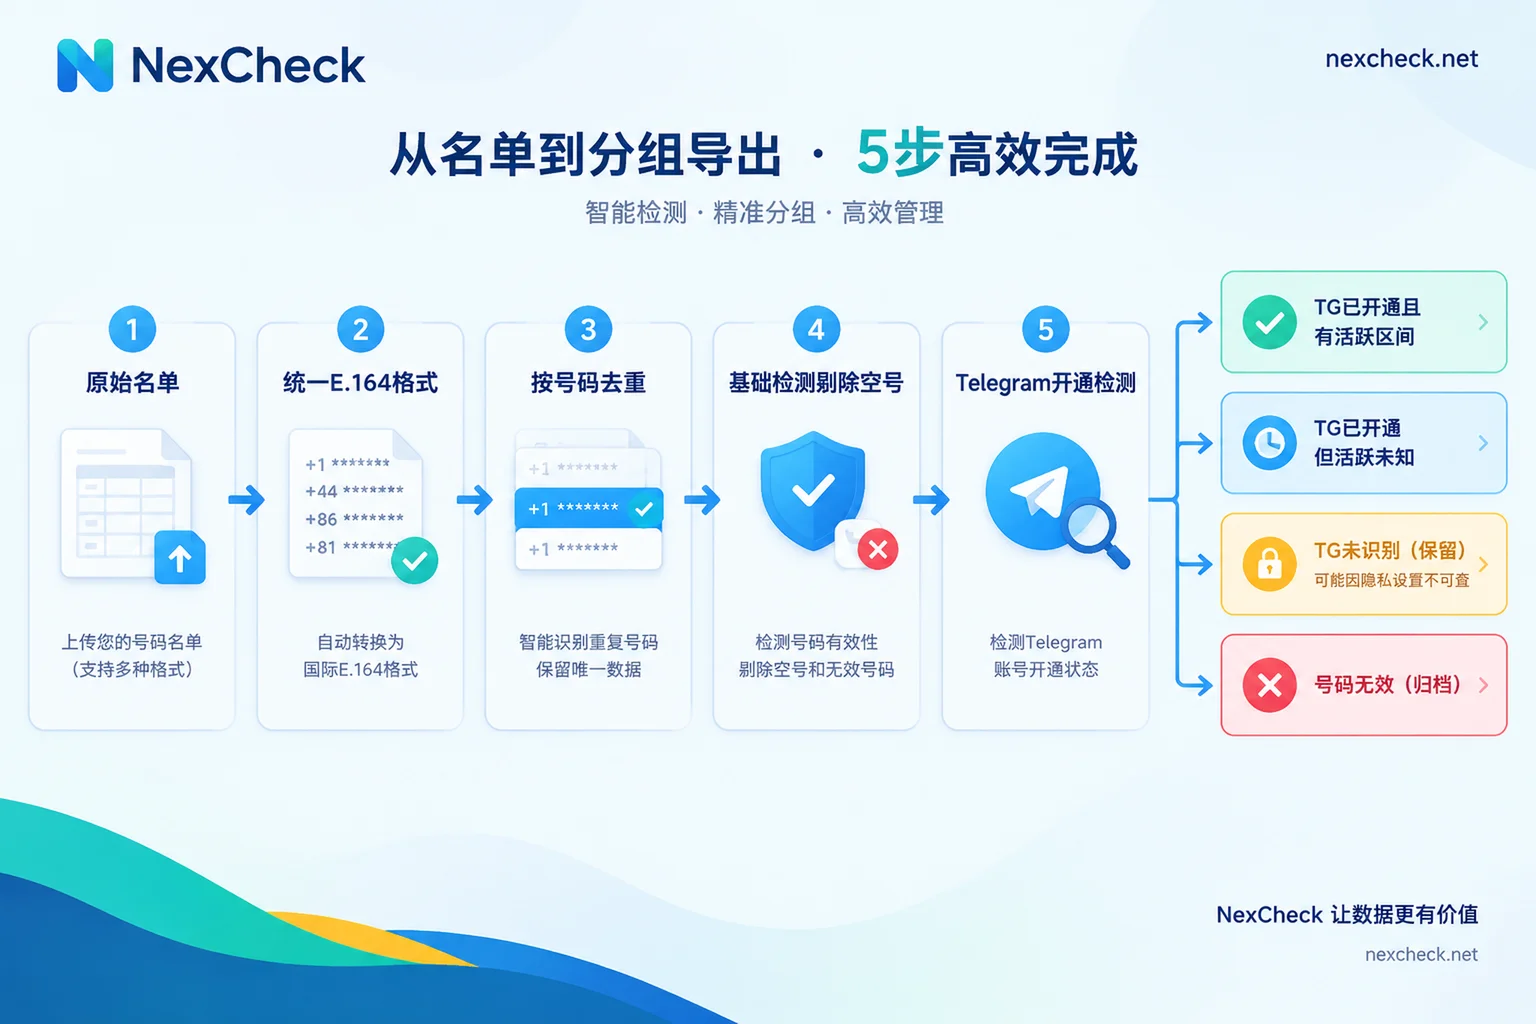
手上有一份客户手机号名单,想知道哪些号码开了 Telegram,这就是常说的 Telegram 号码过滤。处理顺序是:统一格式 → 去重 → 基础检测剔除空号 → Telegram 开通检测 → 分层回写 CRM。
最容易出错的是最后一步。检测结果里的“无效”并不都等于“没开 Telegram”,其中一部分号码已经注册,只是对方的隐私设置让它无法被匹配。如果把这两类当成一回事直接删掉,会误伤一部分真实用户。
开始前先确认名单里有哪些列
先打开文件看一眼,确认名单至少包含以下几列:
- 号码列
- 国家或地区列:没有这一列,后面统一格式会很困难
- CRM 记录 ID 或客户 ID
- 来源字段(可选):之后可以按渠道排查名单质量
客户 ID 最关键。检测服务按号码返回结果,回写 CRM 时要靠这个 ID 把结果对回原来的记录。同一个号码挂在多条记录下时,尤其需要它。
第一步:统一成带国家代码的格式
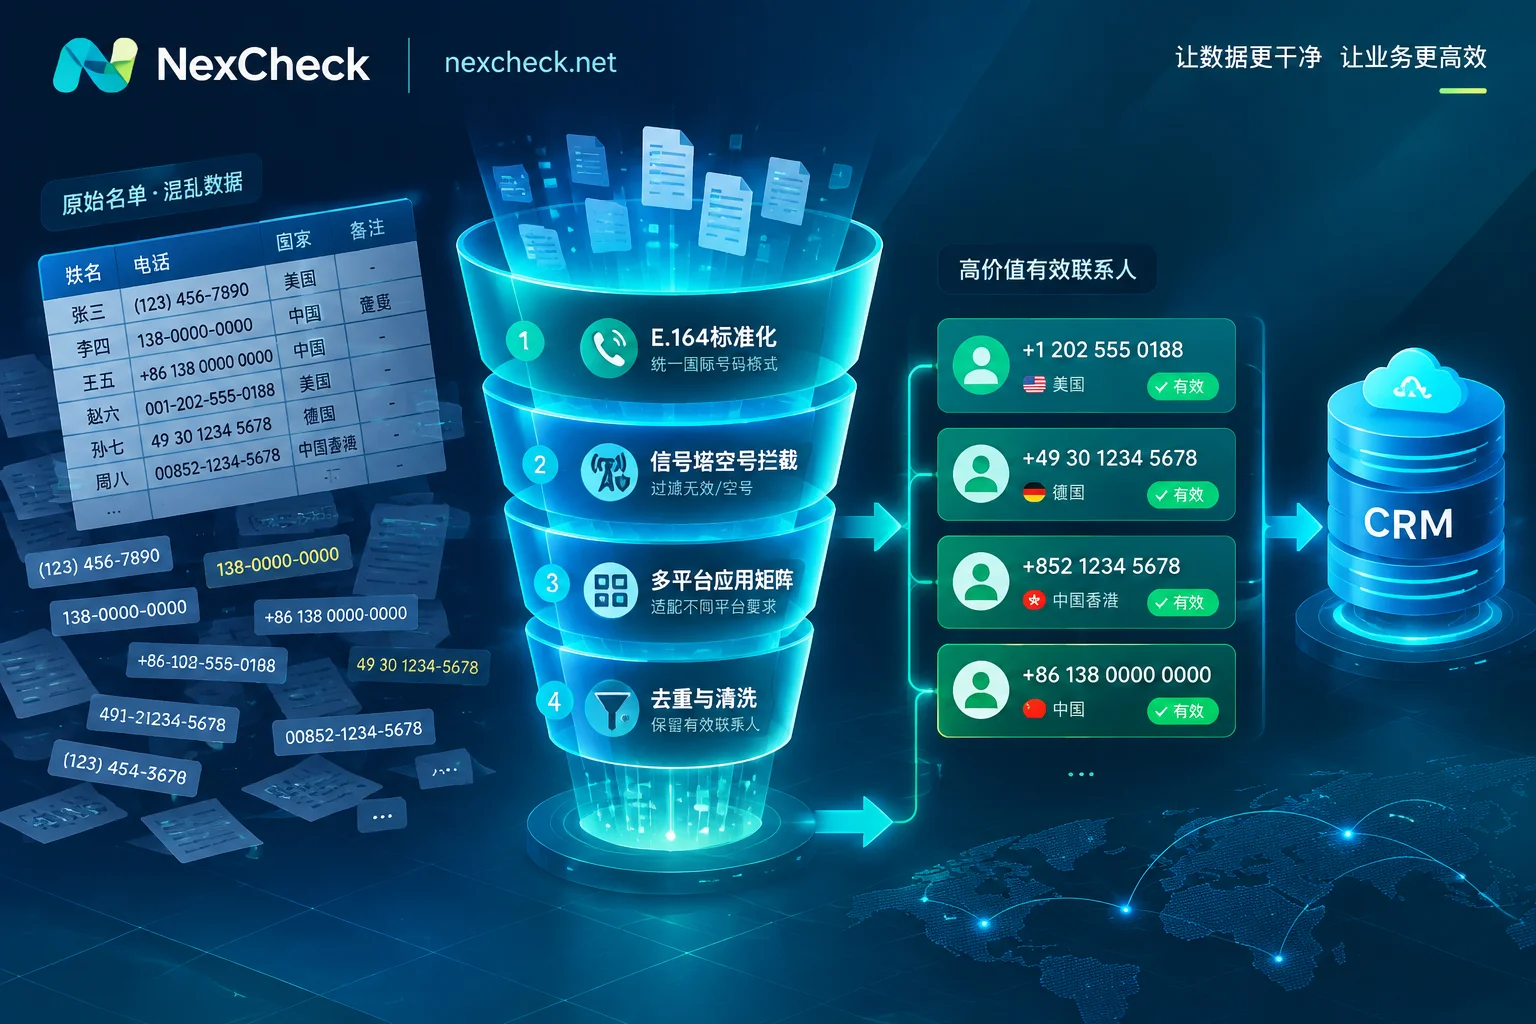
Telegram 用手机号作为账号的底层标识,检测时需要带国家区号的完整号码。名单里常见的写法有很多种:本地格式带前导 0,中间夹着空格、横杠或括号,有的写了 +86 有的没写。这些都要先转成统一的 E.164 写法,也就是“+ 国家代码 + 号码”,同时去掉本地冠码、空格和符号。
实际操作时注意三点:
- 没有国家信息的本地号码不要猜。同一串数字在不同国家可能都是合法号码,区号猜错,检测的就是另一个人。把这类号码单独放一组,回到来源补齐国家信息。
- 多国家名单建议按国家拆开跑。各国号码的长度和前缀规则不同,拆开后出了问题更容易定位,也方便按市场看结果。各国号码格式可以在 NexCheck 区域页 查。
- 格式细节可以参考现成规则。前导零、个别国家的移动号码前缀等问题,见 WhatsApp号码格式错误怎么解决。E.164 的写法在各平台通用。
第二步:按规范后的号码去重
去重要放在统一格式之后。0138... 和 +86 138... 在原始文本里看起来不同,格式化以后才会显示为同一个号码。
去重时保留每个号码和它对应的全部 CRM ID。这样一个号码只检测一次,结果可以回写到每一条相关记录。
第三步:先跑号码基础检测
如果名单来源杂、积累时间长,建议先做一遍号码基础检测,把空号和高风险号码挑出来。检测按条计价,这一步能减少花在明显无效号码上的 Telegram 检测费用。如果名单很新、来源干净,可以视情况跳过。
第四步:Telegram 检测会返回什么
常见的可得信息有三类:
- 是否开通:这个号码能否匹配到 Telegram 账号。
活跃状态:取决于对方“最后上线时间”的隐私设置。
- 对方公开时,可能看到在线或具体上线时间。
- 对方隐藏时,通常只有“最近上线”“一周内”“一个月内”这类模糊区间,也可能完全没有。
- 公开资料:对方自己公开的昵称、用户名(Username)等。
结果按两组返回:有效组是已开通且可以识别的号码,其余进入无效组。具体字段名称和可选检测项会调整,请以 Telegram 平台页 为准。
无效组不等于没有 Telegram
Telegram 的“隐私与安全 > 手机号码”设置里有两项:
- 谁可以看到我的手机号
- 谁可以通过我的手机号找到我
第二项的选项是“所有人”和“我的联系人”。如果对方选了“我的联系人”,而查询方不在对方的通讯录里,任何合规的检测方式都匹配不到这个账号。
所以,无效组里至少混着两类号码:
- 确实没有注册 Telegram 的号码;
- 已经注册,但只允许联系人通过号码找到自己的号码。
从外部无法可靠地区分这两类,也不应该尝试绕过对方的隐私设置。回写 CRM 时,可以按下面的方式分层记录:
| 检测结果 | 实际含义 | CRM 里建议怎么记 |
|---|---|---|
| 有效,有活跃信息 | 已开通,对方公开了上线状态 | TG 已开通,记录活跃区间 |
| 有效,无活跃信息 | 已开通,对方隐藏了上线状态 | TG 已开通,活跃未知 |
| 无效 | 未注册,或因隐私设置查不到 | TG 未识别,保留记录 |
| 基础检测为空号 | 号码本身不可用 | 号码无效,可以归档 |
这张表有三点需要说明:
- “活跃未知”和“不活跃”是两回事。隐藏上线时间是很常见的设置,把这些人当作沉默用户,会低估名单的质量。
- “TG 未识别”的记录不建议直接删除。号码本身可能完全有效,只是在这个平台上查不到。隔一段时间复查,或者参考其他平台的检测结果,都比直接删掉稳妥。
- 回写时带上检测日期。活跃区间只反映检测当时的状态,有了日期才能判断以后要不要重查。
为什么不建议自己写脚本批量匹配
有些团队会考虑直接调用 Telegram 接口自己做号码匹配。Telegram 服务器有防滥用的频率限制:高频导入联系人做匹配,会触发 FLOOD_WAIT 错误,冷却时间从几十秒到一天以上不等,持续触发还可能导致账号被封。官方没有公开具体限额,是实时动态判定的。如果团队需要定期处理名单,自己维护这套脚本的成本和账号风险通常都不划算。
用控制台还是 API
在 NexCheck 处理这份名单时,可以按名单的使用方式来选:
- 一次性或不定期的名单:用控制台。上传 txt 或 csv,选择 Telegram 检测项,跑完后按有效和无效两组导出,再按上面的分层规则导入 CRM。CSV 的整理和上传细节见 Telegram CSV筛号怎么做。
- CRM 持续有新号码进来:用 API。通过 REST API 提交号码,结果用 Webhook 回推,接收端再按客户 ID 更新记录。在你们这边保存好提交批次和 CRM ID 的对应关系,结果到达后才对得上。接口接入的具体做法见 Telegram筛号API怎么接。
费用按条计算,各检测项的单价以平台价目表为准。名单是你们自己的数据,平台只在任务范围内处理;名单的来源和用途是否合法,需要由你们自己保证。
提交前的检查清单
- 所有号码都已转成带国家代码的格式,缺少国家信息的号码已单独列出
- 去重后保留了号码和 CRM ID 的对应关系
- 来源杂的名单已先做基础检测
- 无效组记为“TG 未识别”,没有直接删除
- “活跃未知”和“不活跃”分开记录
- 每条结果都带检测日期
这几项做到了,过滤结果在 CRM 里就能长期使用,下次复查时也知道该从哪一组开始。


评论(0)