 NexCheck-筛号平台
假设你拿到一份从展会登记表、官网表单和老 CRM 导出合并来的 WhatsApp 联系人名单,共一万多行。用 Excel 的「删除重复项」处理后,只少了几百行。但你按姓名抽查时发现,同一个客户仍然出现了三四次,而且每次的号码写法都不一样。
原因是 Excel 只会删除字符完全相同的行。先把每个号码转成统一的规范格式,再用这个规范号码去重,才能找出真正重复的记录。顺序反过来,重复行就会留在名单里,后面按条计费的检测也会为同一个号码多付几次钱。
为什么看起来不重复的号码其实是同一个
以一个英国手机号为例,名单里可能同时出现下面这些写法:
+44 7946 0123450044-7946-01234507946 012345(07946) 012 345447946012345
这五个号码写法不同,但指向同一个号码。差异主要来自三类情况:
- 符号:空格、短横线、圆括号、点号。
- 国际前缀:写成
+,写成国际字冠00,或者没有写前缀。 - 本地拨号习惯:只写了本国的拨号方式,带着国内前导 0(trunk prefix),也没有国家代码。
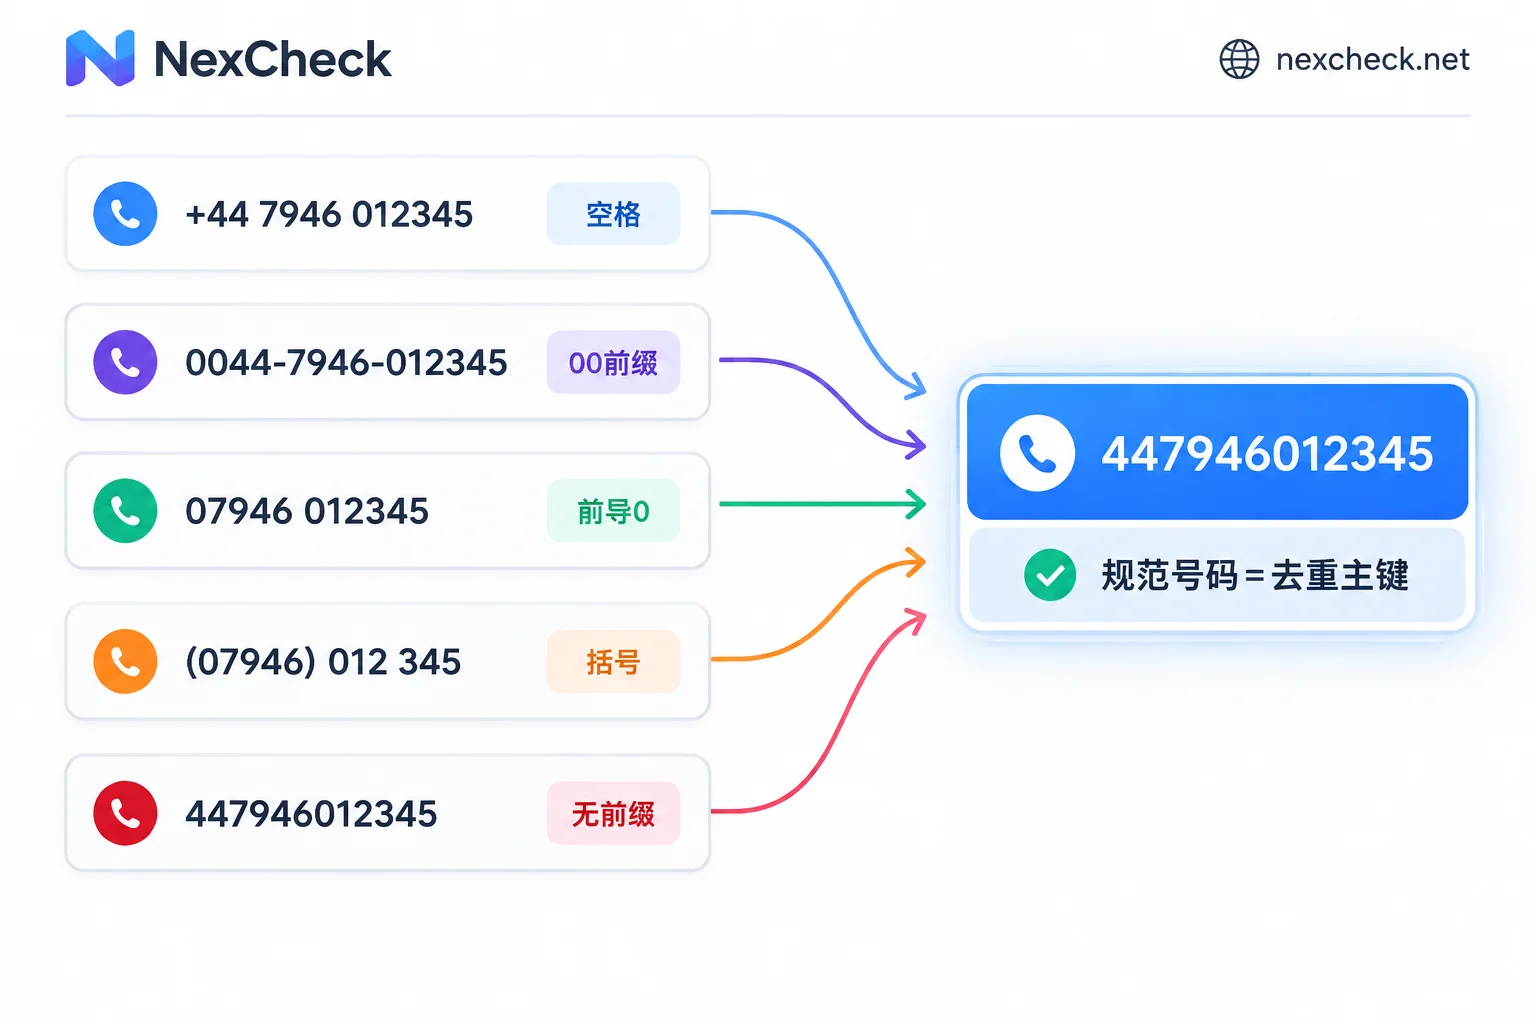
国际电信联盟推荐的 E.164 格式是:+ 加国家代码,再加包含区号的用户号码,总长度不超过 15 位数字。转成国际格式时,要去掉国家代码后面的国内前导 0。比如英国的 07946... 转成 +447946...,德国的 0151... 转成 +49151...。在系统里存储和比对号码时,一般保留带 + 的 E.164 格式,或者只保留纯数字(例如 447946012345)。一份名单里只选一种写法,并且从头到尾保持一致。
处理顺序:先规范化,再去重
第一步:保留原始列,新增一列规范号码
不要直接改原始号码列。新建一列,比如命名为 phone_norm,后面所有清洗操作都写到这一列。原始写法以后排查问题时会用到,把检测结果回写到 CRM 时也需要它。
用 Excel 打开 csv 文件前,先把号码列设成「文本」格式,或者通过「数据 → 从文本/CSV 导入」手动把这一列指定为文本。否则长号码可能变成 4.47946E+11 这样的科学计数法,开头的 0 也会被直接删掉。用 pandas 读取时,同样要加上 dtype=str。
第二步:清洗符号
删除空格、短横线、括号、点号等所有非数字字符,只保留开头的 +。先检查以下两种情况:
- 一个单元格里有多个号码,例如
07946012345 / 07700900123。先拆成多行,再继续清洗。 - 号码后面带分机或备注,例如
ext 12、(微信同号)。先删除这部分内容,否则分机号的数字会被拼进号码里。
第三步:统一国际前缀
- 以
+开头:去掉+,剩下的部分从国家代码开始。 - 以
00开头:去掉00,效果和+相同。 - 部分地区的国际字冠不是
00,比如北美使用011。如果名单主要来自这些地区,要单独处理。
第四步:给本地号码补国家代码、去前导 0
这一步最容易出错。一个以 0 开头的号码,你必须先知道它属于哪个国家,才能正确补上国家代码。判断依据可以是名单里的国家字段、收集渠道(比如某国展会),也可以是客户地址。不要凭号码长度猜测国家。 无法确定国家的号码单独放一组,暂时不参与去重和检测。
确定国家后,再按该国规则处理。多数国家的手机号要去掉前导 0,再在前面补上国家代码。但这条规则不适用于所有号码。例如意大利固定电话在国际格式里仍然保留 0。阿根廷、墨西哥等国的移动号码还有额外的编码规则。多国家名单可以对照 WhatsApp E.164 格式转换规则 逐个国家确认。
如果处理的是单一国家的名单,可以参考下面这段简化逻辑。它只适用于「本地号码带前导 0、去掉 0 后补国家代码」这类国家:
import re

def normalize(raw, cc):  # cc 如英国为 '44'
    s = re.sub(r'[^\d+]', '', str(raw))
    if s.startswith('+'):
        return s[1:]
    if s.startswith('00'):
        return s[2:]
    if s.startswith('0'):
        return cc + s[1:]
    return None  # 不带任何前缀:可能已含国家代码,也可能缺失,交给人工确认
最后一种情况,号码不带 +、00 或 0,比较难判断。447946012345 已经包含国家代码,7946012345 却缺少国家代码。建议把它们单独标记出来,确认后再合并回名单。
第五步:校验长度
把规范化后超过 15 位的号码筛出来,明显过短的号码也一起筛出。这些通常是拼接错误、少录一位或多录一位造成的。先打标记放到一边,不要混进待检测名单。
第六步:按规范号码去重,并保留映射表
用 phone_norm 作为唯一键去重。遇到重复记录时,决定保留哪一条:
- 保留更新时间最新的记录,适合 CRM 导出数据。
- 保留字段最完整的记录,比如有姓名、公司、国家的那一条。
- 如果不同来源的标签都有价值,可以把它们合并到保留的那条记录上。
还有两种情况不要当成重复直接合并。第一种是同一个人登记了两个不同号码,这是两个号码,应该分别检测。第二种是同一个号码对应不同联系人,比如家庭或公司共用一个号码。这时号码只需要检测一次,但联系人记录是否合并,要由业务规则决定。
去重时另外保存一张映射表:原始记录ID → phone_norm。检测结果只会对应到去重后的号码。有了这张表,才能把结果回写到每一条原始记录,包括被合并掉的重复行。
把去重后的名单交给检测
完成以上步骤后,你手上会有一份每行一个规范号码的名单。多国家名单可以按国家代码拆成几个文件,方便分别核对格式和结果。各国的号码格式和常用平台可以在 区域页 查看。
在 NexCheck 上可以用两种方式提交名单。一种是在控制台上传 txt 或 csv 文件,另一种是通过 REST API 提交,单批不限量。系统按 WhatsApp 平台的检测项返回结果,包括是否已开通、注册时间、活跃状态等可以获取的属性,并按有效和无效分组导出。结果也可以通过 Webhook 回推到你的系统。检测按条计价,所以名单里每多一行重复号码,就多一条检测费用。上传含重复号码的名单时,平台是否会自动合并或免计重复行,请以官网说明为准。最稳妥的做法是在本地完成去重后再提交。WhatsApp 的具体检测项和单价会调整,以 WhatsApp 平台页 的价目表为准。名单属于你自己的数据,来源和用途需要合法。
拿到结果后,用第六步的映射表把状态字段回写到原始记录。各个字段的含义和回写顺序,可以接着看 WhatsApp 筛号结果怎么看。


评论(0)