 NexCheck-筛号平台
做 WhatsApp号码过滤,最常见的失败不是检测工具不行,而是顺序反了:名单还没标准化就直接扔进检测,结果里一大片“无效”,其实只是号码前面多了个 0。
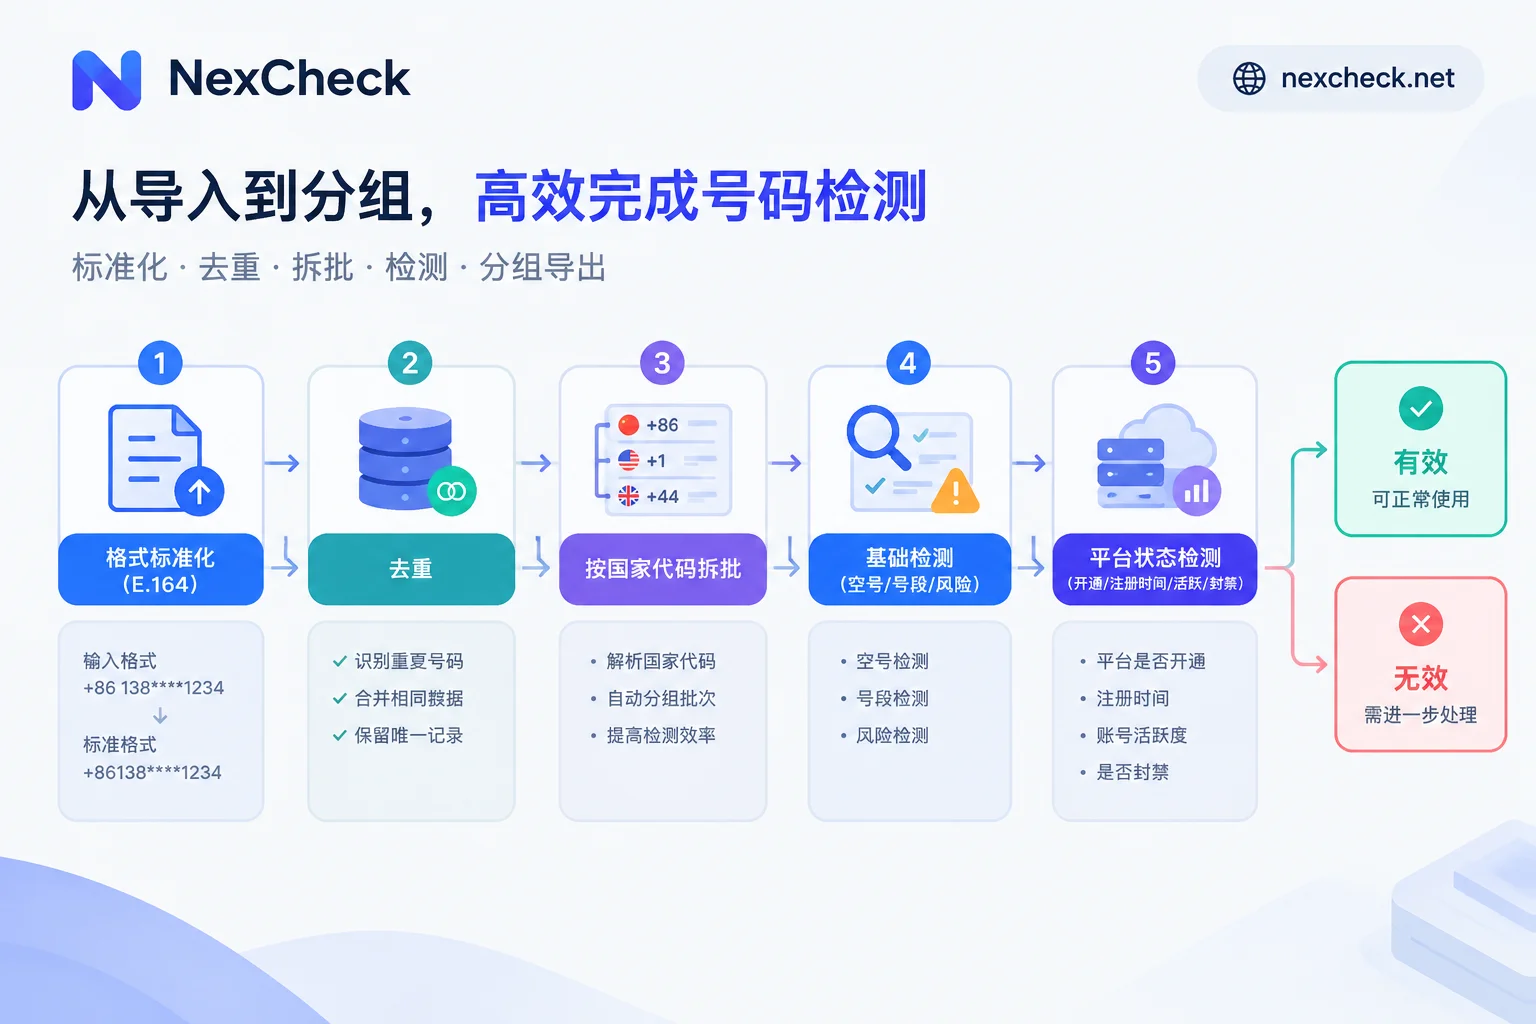
正确的处理顺序是固定的五步:格式标准化 → 去重 → 按国家拆批 → 基础检测 → WhatsApp 平台状态检测 → 按有效/无效分组导出或回写。前三步在你自己的表格或脚本里完成,后两步交给检测平台。每一步做对了,最后那份“有效名单”才有意义。
第一步:把号码改写成 E.164 纯数字
这一步决定后面所有判断的可信度,也是最容易被跳过的一步。
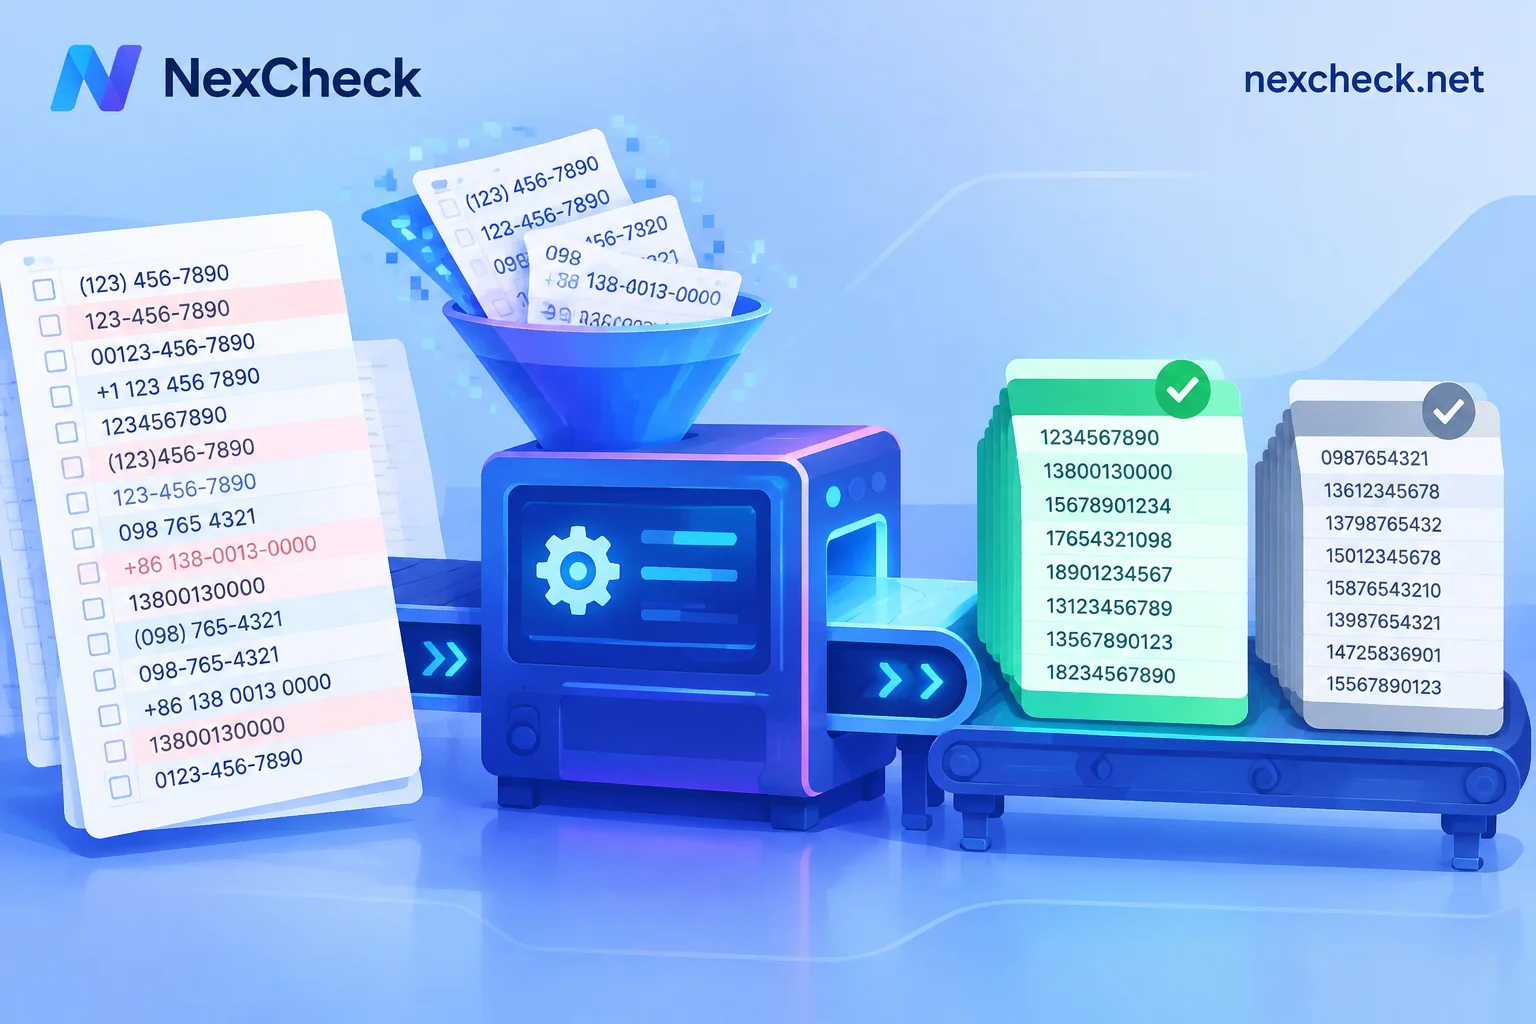
WhatsApp 对国际号码的要求就是 E.164 规范:国家代码开头,后接区号和本地用户号码,并且必须严格去掉两类东西:
- 本地拨号前缀。很多国家在国内拨号时要在区号前加一个“0”,这个 0 在国际格式里必须删掉。英国、德国、意大利之外的多数欧洲国家、以及大量亚洲国家的存量名单都有这个问题。
- 所有分隔符号。括号、横杠、空格、点,全部去掉,只留数字。
至于要不要保留开头的 +,看你用的接口要求:有些接口接受 +8613800138000,有些要求纯数字 8613800138000。提交前统一成一种,不要一份名单里两种混着。
几个必须单独处理的国家
有些国家的规则不是“删掉 0”这么简单,漏掉会让有效号码被判成无效:
- 阿根廷(国家码 54):需要在国家码和区号之间保留一个 9,同时移除本地常用的 15 前缀,最终是 13 位数字。也就是
54+9+ 区号 + 去掉 15 之后的号码。 - 墨西哥(国家码 52):需要在国家代码后包含一个 1。
这类特殊前缀的转换如果没做,号码在格式层面就已经错了,任何检测平台返回的结果都只能是“不存在”。名单里只要有拉美号码,就先把这两条规则写进清洗脚本。
没有国家码的老名单怎么办
存量 CRM 里经常有一批只有本地号码、没有国家码的记录。处理原则是按记录来源补,不要统一猜:如果这批数据来自某个国家站点的注册表单,就按那个国家补;如果来源不明,单独拉出来当作一个待确认批次,不要和已知来源的号码混在一起跑,否则你分不清返回的“无效”是号码本身的问题还是你补错了国家码。
第二步:标准化之后再去重
顺序不能颠倒。+86 138-0013-8000、008613800138000、13800138000 在字符串层面是三条不同记录,去重前必须先统一成同一种写法,否则同一个人会被重复检测三次,按条计价的话就是三倍成本。
去重时给每条号码保留一个原始行的主键(CRM 里的客户 ID、订单号或自增序号)。检测结果回来之后,你要靠这个键把状态写回原表,而不是靠号码本身去匹配——号码在标准化过程中已经被改写过了。
第三步:按国家代码拆分批次
多国混在一张表里跑,技术上可行,但有三个理由建议拆开:
- 格式规则是按国家生效的。拆开之后,阿根廷那一批统一应用 9/15 规则,不会误伤别的国家。
- 错误好定位。如果某个国家整批返回异常,你能立刻看出是这个国家的编号规则没处理对,而不是在几万条混合结果里大海捞针。
- 不同市场的主流通讯平台不一样。巴西、印尼、印度、墨西哥这些市场做 WhatsApp 过滤很合理;但如果名单里混着俄语区或东亚市场的号码,对这部分做 WhatsApp 检测的意义就有限,该换平台检测的换平台。各国的号码格式和当地主流平台可以先在区域方案页对一遍再决定怎么分批。
第四步:先做基础检测,再做平台检测
这一步是分层的,顺序上先粗后细:
基础检测看的是号码本身的通信属性——是否空号、号段类型(移动/固话/虚拟号)、是否属于高风险号段。这一层能把明显没救的号码先剔掉。
平台状态检测才是真正的 WhatsApp号码过滤:这个号码在 WhatsApp 上是否开通、注册时间、活跃情况、是否封禁,以及部分可得的画像属性。
先基础后平台的好处是成本:按条计价的模式下,先用较便宜的一层筛掉空号和无效号段,剩下的再进平台检测,总账会更好看。名单质量本来就不错、或者量不大的时候,也可以直接跑平台检测,这一层不是强制的。
处理你手上这份名单时,两种提交方式都可以:在 NexCheck 控制台直接上传 txt 或 csv,单批不限量;或者用 REST API 提交任务,完成后通过 Webhook 回推结果。返回结果按有效与无效分组,可以直接导出两份名单。具体能查哪些字段、各字段单价多少,以平台页上的检测项清单和价目表为准——检测项和价格会调整,别照抄别人博客里的旧列表。名单是你自己的数据,平台只在任务范围内处理,但号码来源和使用用途的合法性需要你这边保证。
字段怎么读:三个容易读错的地方
拿到结果之后,别把所有字段都当成同等强度的证据。
头像、签名、最后上线受用户隐私设置控制
WhatsApp 原生提供隐私控制:头像(Profile Photo)、关于(About)、最后上线(Last Seen) 都可以由用户设置为“所有人”“我的联系人”“我的联系人除外”或“没有人”。
这意味着一个正常在用的账号,完全可能对不在其通讯录里的外部查询不返回头像和活跃时间。不要把“无头像”“无签名”“查不到最后上线”单向等同于“未开通”或“已弃用”——这是这类名单最常见的误判来源。判断是否开通,就看是否开通这个字段本身;头像和活跃时间只能作为辅助排序的弱信号。
性别、年龄是推断字段
这类画像属性在不同批次的覆盖率差别很大,计算逻辑也因平台而异。合理的用法是拿它做优先级排序或分组,比如把有明确画像的一部分先单独运营;不合理的用法是拿它做硬过滤,把没返回画像的号码整批删掉——你删掉的大概率只是“没查到”,不是“不符合”。
封禁和注册时间
封禁状态是明确的剔除依据。注册时间可以用来判断账号新旧,对区分批量注册号和真实长期用户有参考价值,但它反映的是账号年龄,不直接等于活跃度。
关于字段含义的更细拆解,可以看《WhatsApp号码有效性检测怎么做?从名单格式化到状态字段解读》。
网页端还是 API:按频率和是否回写来选
- 一次性清洗、不需要自动回写:用控制台上传更快。传 txt/csv,等结果,导出有效/无效两份表,人工导回 CRM 就完事了。
- 周期性跑、或者要写回系统:走 API。新名单入库时自动提交检测,结果通过 Webhook 回推直接更新客户表字段,不用人盯着。对接细节可参考《WhatsApp筛号API怎么接入?从异步任务到Webhook回写的完整对接方案》。
- 拿不准用轮询还是 Webhook:量小、对延迟不敏感的可以轮询;批量大或任务耗时长的用 Webhook 更省资源,这篇按任务量做了分档。
结果落库:别只存“有效/无效”
很多团队把结果压缩成一个布尔字段存回 CRM,等于把花钱买来的信息扔掉了大半。建议按多列落库:是否开通、注册时间、活跃信号、封禁状态、检测时间戳,各占一列。
留下检测时间戳尤其重要——号码状态会变,今天有效的号码半年后可能已经弃用。有了时间戳,你才能设定复检周期,只对超过某个天数的记录重跑,而不是每次把整库再刷一遍。这部分的落库结构可以参考《批量号码验证别只看有效无效,结果要按多列落库》。
几个常见的坑
- Excel 把号码存成了科学计数法或吞掉了前导符号。导出 csv 前把号码列设成文本格式,导出后随机抽查几行。
- 整批返回异常先怀疑格式。某个国家整片无效,九成是编号规则没处理对,先回到第一步复查,而不是换平台。
- 不同平台的检测项不通用。WhatsApp 能查到的字段和其他通讯平台能查到的字段不是一套,别把某个平台的字段清单套到所有工具上,具体以各平台页的说明为准。
- 检测频率的风控参数没有公开标准。各家平台的检测通道和处理策略不同,不要照搬网上流传的“安全间隔”数字,按你使用的平台的实际返回情况来。
把前三步在自己这边做扎实,后面的检测才是在回答真问题。顺序对了,一份混乱的多国名单也能在一轮处理内变成可用的分组结果。


评论(0)